競馬AIを運用していると、モデルを一度作って終わりにはできないような気がしてきます。
毎週新しいレースが行われ、新馬がデビューし、条件戦を勝ち上がる馬が現れます。騎手の成績も変わりますし、競馬場の傾向や馬場状態、血統の勢力図も少しずつ変化していきます。
そう考えると、
「毎週最新データを追加して学習し直した方が強くなるのでは?」
と思いたくなります。
一方で、毎週モデルを更新すれば本当に性能が改善するのでしょうか。直近数週間の結果を強く反映しすぎることで、偶然の好不調まで学習してしまう可能性もあります。
例えば、ある騎手が3週間だけ絶好調だった。その期間を含めてモデルを更新した結果、その騎手を過大評価するようになった。翌月には成績が平均へ戻り、モデルだけが高評価を続ける。
こうしたことも考えられます。
競馬AIにとって重要なのは、単純に「最新のデータを入れること」ではなく、
どのくらいの速度で競馬という環境が変化しているのか
を見極めることなのかもしれません。
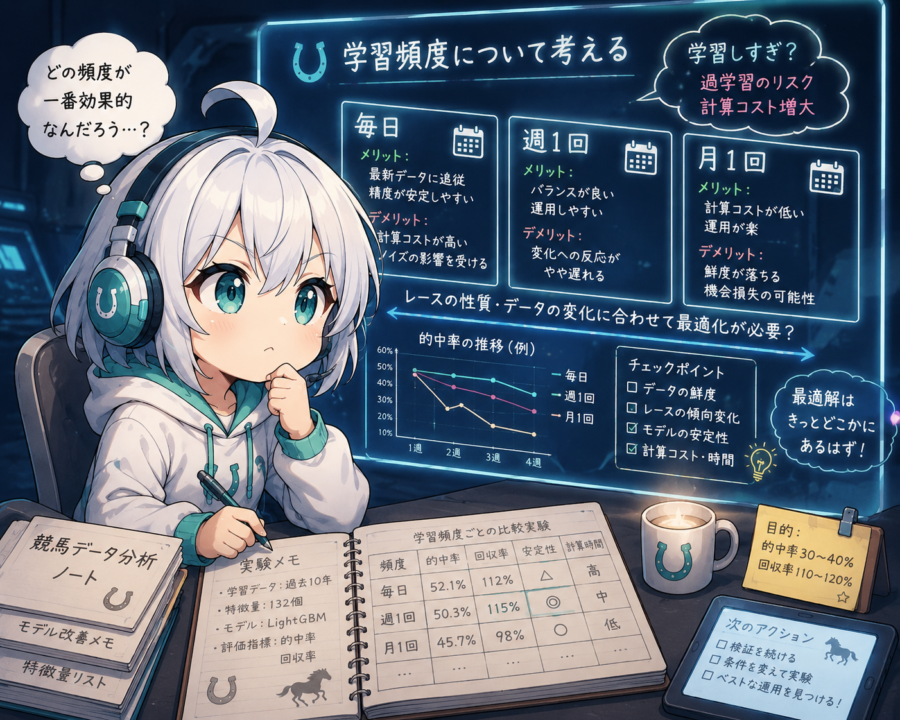
今回は、競馬AIはどれくらいの頻度で学習し直すべきなのかを、毎週・毎月・数か月ごとの再学習、それぞれのメリットと弱点から考えてみます。

- 一度作ったAIをずっと使い続けるのは少し不安
- 競馬にも「概念ドリフト」はあるのか
- では毎週学習し直せば一番新鮮なのか
- 頻繁な再学習は「最新情報を追う」だけではない
- 月1回くらいが一つの現実的な候補になる
- 3か月ごとでも意外と十分かもしれない
- 学習頻度より「どの期間を学習するか」の方が重要かもしれない
- 「全期間」と「ローリング学習」はどちらがよいのか
- 生涯成績と直近成績を両方持つ方法もある
- 「最新データを使う」と「モデルを作り直す」は別
- 再学習よりキャリブレーション調整だけでよい場合もある
- 「最近負けているから再学習」は危険
- 再学習したら必ず新モデルを採用する必要はない
- 比較するなら回収率だけでは足りない
- 「いつ学習するか」より「未来データを混ぜない」が最優先
- 個人的には「月1回再学習+毎週データ更新」から試したい
- 最適な再学習頻度そのものをバックテストできる
- 季節単位で変わる特徴量もありそう
- モデル更新履歴を残しておきたい
- 更新頻度を高くしすぎると「何が効いたのか」が分からなくなる
- 最終的には「時間で更新」だけでなく「性能で更新」したい
- 「よく学習するAI」より「更新理由を説明できるAI」
- まとめ
一度作ったAIをずっと使い続けるのは少し不安
まず、一度学習したモデルを何年もそのまま使い続ける方法について考えます。
例えば2015~2025年のデータでモデルを作り、2026年以降も一切学習し直さず予測する。
理論上は可能です。
過去10年以上のレースが入っていれば、十分なサンプル数があります。競馬という競技の基本構造も急激には変わりません。芝1200mが突然3000mになったり、斤量制度が毎週変更されたりするわけではありません。
それなら、一度しっかり学習したモデルを長く使うことにも一定の合理性があります。
ただし、競馬の中身は少しずつ変わります。
騎手が引退し、新しい騎手が増えます。種牡馬の勢力も入れ替わります。馬場管理や開催条件が変わることもあります。調教師や厩舎の成績も変動しますし、馬齢ごとの競走体系も長期的には変化します。
さらに、AIが利用する特徴量によっては鮮度の影響が大きくなります。
例えば、
騎手の直近成績。
調教師の近年成績。
種牡馬のコース別成績。
人気と着順の関係。
脚質ごとの有利不利。
こうしたデータは、5年前と現在で同じとは限りません。
つまり競馬AIも、長く放置すれば少しずつ現在の環境から離れていく可能性があります。
競馬にも「概念ドリフト」はあるのか
機械学習では、時間の経過によってデータと結果の関係が変わることを「概念ドリフト」と呼ぶことがあります。
簡単に言えば、
昔は当たっていた法則が、今も同じように当たるとは限らない
という話です。
競馬でも考えられます。
例えば、ある血統が中距離で非常に強かった時期があったとしても、その種牡馬の産駒が減れば重要度は下がります。逆に新しい種牡馬が登場すれば、過去データがほとんどないまま勢力を拡大することがあります。
騎手も同様です。
若手騎手が数年間で急成長すれば、デビュー直後を含めた通算成績だけでは現在の実力を正確に表せないかもしれません。
さらに馬券市場そのものも変化します。AI予想やデータ分析が普及すれば、以前は市場で見落とされていた条件が現在ではオッズへ反映されやすくなる可能性があります。
競馬のルール自体は同じでも、予測対象となる環境は少しずつ動いていると考えた方が自然でしょう。
では毎週学習し直せば一番新鮮なのか
ここで最も単純な答えが出てきます。
毎週末のレースが終わったら、そのデータを追加して月曜日にモデルを再学習する。
これなら常に最新です。
例えば先週までのデータを使って今週を予測するので、未来情報が混ざらないように管理できれば、運用方法としては分かりやすいです。
毎週再学習するメリットは、当然ながらデータの鮮度です。
新しくデビューした馬や騎手の成績を早く反映できますし、新種牡馬の傾向も蓄積されるたびにモデルへ入ってきます。
直近の競馬場傾向などを特徴量として使っている場合も、更新頻度が高い方が現在の状態を捉えやすくなります。
ただし、ここで一つ疑問があります。
JRAでは毎週多くのレースが行われますが、10年以上の学習データ全体から見れば、1週間分の追加データはそれほど大きくありません。
既に数万レースを学習しているモデルへ、新しく数十レース追加したからといって、予測結果が劇的に変わるとは限りません。
毎週再学習するコストに対して、得られる改善が非常に小さい可能性もあります。
頻繁な再学習は「最新情報を追う」だけではない
さらに注意したいのが、再学習するたびにモデルが少しずつ変わることです。
例えば先週までAI指数1位だったタイプの馬が、今週の再学習後には2位になった。
何が起きたのか。
新しいレースデータが追加されたことで、本当にモデルが改善したのかもしれません。
しかし単なる学習時の揺らぎや、直近データの偶然の偏りを拾っただけかもしれません。
特に直近データへ強い重みを付けているモデルでは、「今週起きたこと」を過剰に学習する危険があります。
例えば雨開催が続き、逃げ・先行馬が大量に好走した。
そこで更新したモデルが、
「最近は前へ行く馬が強い」
と学習する。
しかし翌週は良馬場へ戻る。
この場合、最新データを入れたことが必ずしもプラスになりません。
つまり、
最新=正しい
ではありません。
競馬では一週間単位の結果にかなり偶然が含まれるからです。
月1回くらいが一つの現実的な候補になる
そこで現実的な候補として考えやすいのが、月1回の再学習です。
4~5週分の新しいデータをまとめて追加してモデルを更新します。
毎週よりデータ量が増えるため、一週だけの特殊な結果に振り回されにくくなります。一方、半年や一年放置するほど古くもなりません。
競馬AIのように、毎週大量のレースを予測しながら少しずつ新データが追加されるモデルなら、個人的にはかなり扱いやすい頻度に見えます。
例えば月初に、
先月までのデータを追加。
モデル再学習。
キャリブレーション確認。
過去モデルとの比較。
問題なければ新モデルへ切り替え。
という運用ができます。
この方法なら、「モデルを更新した結果、本当に良くなったのか」を確認する時間も取れます。
毎週機械的に上書きするより、モデルの変化を観察しやすいのもメリットです。
3か月ごとでも意外と十分かもしれない
さらに更新頻度を落として、四半期ごとに再学習する方法もあります。
競馬は、スマートフォンアプリの流行やSNSのトレンドのように、数週間で世界が完全に変わるものではありません。
馬の能力、距離適性、血統、枠順、斤量といった基本構造は比較的安定しています。
そのため、モデルの中心が長期的な競走成績であれば、3か月ごとでも大きな問題が起きない可能性があります。
むしろモデルを頻繁に変更しないことで、同じモデルを一定期間使い続けられるメリットがあります。
例えば3か月間固定したモデルで1,500レース予測したなら、その期間の成績をきれいに評価できます。
毎週モデルを変えると、
1週目モデルA。
2週目モデルB。
3週目モデルC。
となり、「今使っているAIが本当に強いのか」が評価しにくくなります。
モデルそのものを観察するという意味では、ある程度固定期間を持たせることも重要です。
学習頻度より「どの期間を学習するか」の方が重要かもしれない
ここまで再学習の頻度を考えてきましたが、実はもっと重要な問題があります。
それは、
過去何年分を学習データとして残すのか
です。
例えば毎月再学習するとしても、
2010年以降すべて。
直近10年。
直近5年。
直近3年。
では、モデルの性格がかなり変わります。
過去データを長く残すほどサンプル数は増えます。珍しい条件でも学習しやすくなり、モデルは安定します。
一方、古い競馬環境も含まれます。
直近3年だけなら現在の競馬に近いですが、データ量が少なくなります。
つまり、
更新頻度と学習期間はセットで考える必要があります。
毎週再学習していても、過去15年のデータを全部入れているなら、直近1週間の影響はほとんどありません。
反対に直近1年だけで学習しているなら、一週間の追加でもモデルが大きく変わります。
「全期間」と「ローリング学習」はどちらがよいのか
学習期間には大きく二つの考え方があります。
一つは、過去データをどんどん積み上げる方法です。
2015年から開始したなら、
2025年モデル=2015~2024年
2026年モデル=2015~2025年
2027年モデル=2015~2026年
と増えていきます。
もう一つがローリング方式です。
例えば直近5年だけ使うなら、
2025年モデル=2020~2024年
2026年モデル=2021~2025年
2027年モデル=2022~2026年
となります。
前者はサンプル量を重視。
後者はデータ鮮度を重視します。
競馬AIでは、どちらが正しいとは簡単に言えません。
例えば枠順や距離のような比較的安定した特徴なら古いデータも役立ちそうです。
しかし騎手や種牡馬の評価では、10年前の成績が現在と同じ意味を持つとは限りません。
特徴量によって必要な鮮度が違うため、本当はすべて同じ期間で集計する必要すらないのかもしれません。
生涯成績と直近成績を両方持つ方法もある
例えば騎手特徴量なら、
騎手通算勝率。
直近3年勝率。
直近1年勝率。
直近90日勝率。
を同時に作れます。
これなら長期的な実力と直近の状態を両方モデルへ渡せます。
種牡馬でも同じです。
通算芝勝率。
直近3年芝勝率。
当該世代勝率。
などを使えます。
この方法を取れば、モデル全体を毎週学習し直さなくても、入力特徴量だけ最新状態へ更新するという選択肢も出てきます。
ここは重要です。
競馬AIの更新というと、すぐに「モデル再学習」を想像します。
しかし、
データを更新する。
特徴量を更新する。
確率を補正する。
モデルを再学習する。
は別の処理です。
毎週必要なのはデータ更新だけで、モデル学習は月1回でもよいかもしれません。
「最新データを使う」と「モデルを作り直す」は別
例えば騎手の直近30日勝率という特徴量を使っているとします。
今週の予測では、当然今週時点までの成績から直近30日勝率を計算します。
これはモデルを再学習しなくても可能です。
モデルは、
「直近30日勝率が高い騎手にはどの程度の意味があるか」
を過去データからすでに学んでいます。
その入力値だけ最新へ差し替えればよいわけです。
つまり、
最新の情報を使いたいから毎週再学習しなければならない
とは限りません。
この区別をすると、更新頻度をかなり整理しやすくなります。
再学習よりキャリブレーション調整だけでよい場合もある
競馬AIでp_winを使うなら、もう一つ考えたいのが確率のキャリブレーションです。
モデルの順位付け能力は変わっていないのに、
p_win 0.30と予測した馬が最近は25%程度しか勝っていない。
こういうことが起きた場合、モデル全体を作り直さなくても、確率補正だけ調整する方法があります。
例えば、
予測順位は優秀。
AUCなども大きく変わらない。
しかしp_winが全体的に強気になっている。
なら、問題は「誰が強いか」ではなく「どのくらい強いか」の部分です。
競馬で期待値を計算する場合、
p_win × オッズ
を使うので、確率のズレはかなり重要です。
再学習の必要性を判断するときには、単なる的中率だけでなく、
予測順位と確率精度のどちらが悪化しているのか
を分けて考えたいところです。
「最近負けているから再学習」は危険
競馬AIを運用していると、最も再学習したくなるのは負けているときです。
直近50レースで回収率65%。
指数1位も全然来ない。
すると、
「モデルが古くなったのでは?」
と思います。
しかし前回考えた「確率は収束する」とも関係しますが、50レース程度の不調は単なる下振れかもしれません。
そこでモデルを変更すると、偶然負けた期間に合わせて学習することになります。
逆に直近50レースで回収率180%だったときには、モデルを変えようとは思わないでしょう。
つまり、
成績が悪いときだけ再学習する
という運用自体に人間の心理バイアスが入り込みます。
更新ルールは、成績を見る前に決めておいた方がよさそうです。
例えば「毎月第1週に再学習候補を作る」と固定する。
これなら好調でも不調でも同じ条件で更新できます。
再学習したら必ず新モデルを採用する必要はない
ここも重要です。
月1回再学習すると決めたからといって、毎月新モデルへ切り替える必要はありません。
例えば、
現在モデルA。
最新データを加えてモデルBを作成。
そして同じ検証期間で比較します。
モデルAの方が良ければ、そのまま使う。
モデルBが明確に改善していれば更新する。
これなら、
再学習=更新
ではなく、
再学習=候補モデルを作る
と考えられます。
競馬AIは実戦でお金を使うモデルなので、「最新だから」という理由だけで自動的に差し替えるより安全です。
比較するなら回収率だけでは足りない
新旧モデルを比較するとき、回収率だけを見ると危険です。
例えば検証期間500レースで、
旧モデル回収率95%。
新モデル110%。
なら新モデルが良さそうです。
しかし新モデルが単勝50倍を一度当てただけで110%になっている可能性があります。
そのため、
指数1位勝率。
複勝率。
Log Loss。
Brier Score。
キャリブレーション。
人気別成績。
オッズ帯別成績。
最大払戻を除いた回収率。
なども見たいところです。
競馬AIの場合、予測モデルそのものの性能と馬券戦略の成績は分けて確認した方がよいと思います。
新モデルの予測精度は改善しているのに、たまたま検証期間の回収率が低いこともあり得ます。
「いつ学習するか」より「未来データを混ぜない」が最優先
再学習を頻繁にすると、データ管理も複雑になります。
例えば2026年8月30日のレースを予測するモデルなら、当然そのレース結果を学習データへ含めてはいけません。
これは当たり前です。
しかし騎手勝率や馬の過去成績、人気情報などを集計するとき、知らないうちに未来データが混ざることがあります。
例えば2025年のレースをバックテストしているのに、特徴量として「2025年年間騎手勝率」を使ってしまう。
その数字には12月までの結果が含まれています。
1月時点では知ることのできなかった未来情報です。
再学習頻度を細かくするほど、こうした時間管理は重要になります。
「毎週再学習」という高度な運用をする前に、
その時点で本当に知ることのできた情報だけで特徴量を作れているか
を確認する方が優先順位は高いでしょう。
個人的には「月1回再学習+毎週データ更新」から試したい
もし現在の競馬AIで運用ルールを作るなら、最初はこのくらいが扱いやすい気がします。
毎週末、最新レースデータをデータベースへ追加します。
騎手成績、馬の戦績、直近成績などの特徴量は毎週更新します。
一方、LightGBMなどのモデル本体は月1回だけ再学習します。
そして新モデルは自動採用せず、旧モデルと検証します。
新モデルが同程度以上なら更新。
明らかに悪化したら旧モデルを継続。
これなら鮮度と安定性のバランスを取りやすそうです。
さらに半年ほど運用してから、
毎週。
月1回。
3か月ごと。
の再学習モデルを並行して作り、実際にどれが良かったか比較すればよいでしょう。
最適な再学習頻度そのものをバックテストできる
考えてみれば、「何日に一度学習するべきか」も仮説の一つです。
ならばデータで検証できます。
例えば過去数年間について、
モデルA
毎週再学習。
モデルB
毎月再学習。
モデルC
3か月ごとに再学習。
モデルD
年1回再学習。
として、時系列バックテストを行います。
各モデルについて、
勝率。
回収率。
Log Loss。
Brier Score。
キャリブレーション。
モデル更新にかかる処理量。
を比較します。
もし毎週更新しても月1回とほとんど差がなければ、毎週学習する意味は薄いでしょう。
逆に毎週モデルだけ明確に改善するなら、頻繁に更新する価値があります。
「競馬AIは月1回再学習すべき」と一般論で決めるより、
自分のAIにとって最適な頻度を検証する
方がずっとAIらしい答えです。
季節単位で変わる特徴量もありそう
競馬には季節性もあります。
夏競馬。
冬場。
3歳春。
2歳新馬シーズン。
開催競馬場。
このように一年を通じて出走馬の構成が変わります。
例えば6月になると2歳新馬戦が始まります。
秋には3歳馬と古馬の力関係も変わってきます。
こうした季節性を考えると、単純な「30日ごと」だけでなく、
競馬カレンダー上の節目でモデルを確認する
方法もありそうです。
年始。
クラシック開始前。
夏競馬。
秋競馬。
などです。
ただし季節ごとに別モデルを作れば必ず強くなるわけではありません。
細分化するほどサンプル数が減るからです。
ここでも最終的には検証が必要になります。
モデル更新履歴を残しておきたい
再学習を始めると、モデル管理が重要になります。
例えば、
v1.0 2026年1月学習
v1.1 2026年2月学習
v1.2 2026年3月学習
のように保存します。
そして各モデルについて、
学習期間。
特徴量。
ハイパーパラメータ。
検証成績。
実戦成績。
を記録します。
これをしないと、半年後に、
「今のモデルっていつのデータまで入っていたっけ?」
となります。
さらに成績が悪化したとき、以前のモデルへ戻すこともできません。
競馬AIを長期運用するなら、モデルそのものより、
どのモデルがいつどんな条件で使われていたか
という履歴が重要になってきます。
更新頻度を高くしすぎると「何が効いたのか」が分からなくなる
例えば今週、
新データ追加。
特徴量追加。
ハイパーパラメータ変更。
学習期間変更。
モデル再学習。
を全部同時に行ったとします。
翌週、成績が改善しました。
しかし何が効いたのか分かりません。
逆に悪化しても原因が分かりません。
AI開発では改善したくなるほど、多くの変更を一度に入れがちです。
しかし競馬AIを観察するなら、
一度に変えるものをできるだけ少なくする
方がよさそうです。
月1回再学習だけする。
特徴量追加は別のタイミング。
学習期間変更も別テスト。
と分ければ、それぞれの効果を確認できます。
最終的には「時間で更新」だけでなく「性能で更新」したい
さらに発展させるなら、決まった日数ではなく、モデル性能が悪化したときに再学習する方法もあります。
例えば直近500レースについて、
予測確率と実勝率の差が一定以上。
Log Lossが過去平均より大きく悪化。
指数1位勝率が想定レンジを外れる。
特定オッズ帯でキャリブレーションが崩れる。
といった条件を監視します。
一定以上ズレたら、モデルの再学習を検討します。
これは、
カレンダーではなくモデルの状態を見て更新する
方法です。
ただし短期的な下振れをモデル劣化と誤認しないよう、十分なサンプル数が必要です。
最初からここまで複雑にする必要はありませんが、長期運用では面白いテーマだと思います。
「よく学習するAI」より「更新理由を説明できるAI」
競馬AIを作っていると、「最新モデル」という言葉に魅力を感じます。
昨日までの全データを使った最新版。
毎週アップデート。
常に学習。
いかにも強そうです。
しかし競馬の場合、更新回数そのものに価値があるわけではありません。
毎週学習して性能が変わらないなら、更新する意味はほとんどありません。
逆に3か月に一度でも、古くなった傾向を適切に捨てて性能を改善できているなら十分です。
重要なのは、
なぜ今このモデルを更新するのか
を説明できることだと思います。
新しいデータが十分たまった。
キャリブレーションが崩れてきた。
新種牡馬や新騎手のデータが増えた。
旧モデルより新モデルの時系列検証が良かった。
こうした理由があって更新する。
それなら、単なる「最新版信仰」ではなく、データに基づいたモデル運用になります。
まとめ
競馬AIはどれくらいの頻度で学習し直すべきなのか。
最初に考えた「毎週最新データを追加すれば、一番強くなる」というほど単純ではなさそうです。
競馬の環境は少しずつ変わります。騎手、種牡馬、出走馬、馬券市場などが変化する以上、モデルを何年間も完全に放置するのは少し不安があります。
一方で、毎週のレース結果にはかなりの偶然が含まれています。頻繁に学習しすぎれば、最新情報ではなく短期的なノイズを追いかける可能性があります。
そのため、現実的な出発点としては、
データと特徴量は毎週更新し、モデル本体は月1回程度再学習する
くらいが扱いやすそうです。
ただし、これは絶対的な正解ではありません。
毎週再学習。
月1回。
3か月ごと。
年1回。
それぞれを過去データ上で時系列に再現し、予測精度や回収率を比較すれば、自分のAIにとって適切な頻度を調べることができます。
さらに重要なのは、再学習頻度だけではありません。
過去何年分を学習するのか。
古いデータを残すのか。
直近期間だけ使うのか。
特徴量だけ毎週更新するのか。
確率補正だけ変更するのか。
新モデルを自動採用するのか。
こうした運用全体を考える必要があります。
そして成績が悪くなったから慌てて再学習するのも避けたいところです。短期的な下振れをモデル劣化と勘違いすれば、偶然の結果へAIを合わせ続けることになります。
競馬AIを長期運用するなら、目指したいのは「毎週学習するAI」ではなく、
必要なときに、必要な理由で学習し直せるAI
なのだと思います。
最新であることより、更新したことで本当に予測が改善したのか。
そこまで観察できるようになれば、「モデルを作る」という段階から一歩進み、競馬AIそのものを育てていく運用が始まるのかもしれません。
コメント